体验 Speech 语音服务
本章完成两件事:把一段中文生成音频,再上传这段音频得到转写文本。先确认自己正在使用正确的 Foundry 资源和项目;Speech 的区域、并发及计费与 GPT 部署 TPM 分别管理。
先看一次点击演示
Section titled “先看一次点击演示”点击“播放演示”,查看指针移动和点击位置;可以暂停,或逐步查看。演示使用真实页面截图,完整页面和填写说明见下方步骤。
在项目的服务页,点击 Azure 语音卡片。
1. 从项目进入 Azure Speech
Section titled “1. 从项目进入 Azure Speech”操作路径:Foundry → 顶部 Build(本次中文页面显示“版本”)→ 左侧“服务 / Services”→“Azure 语音”。

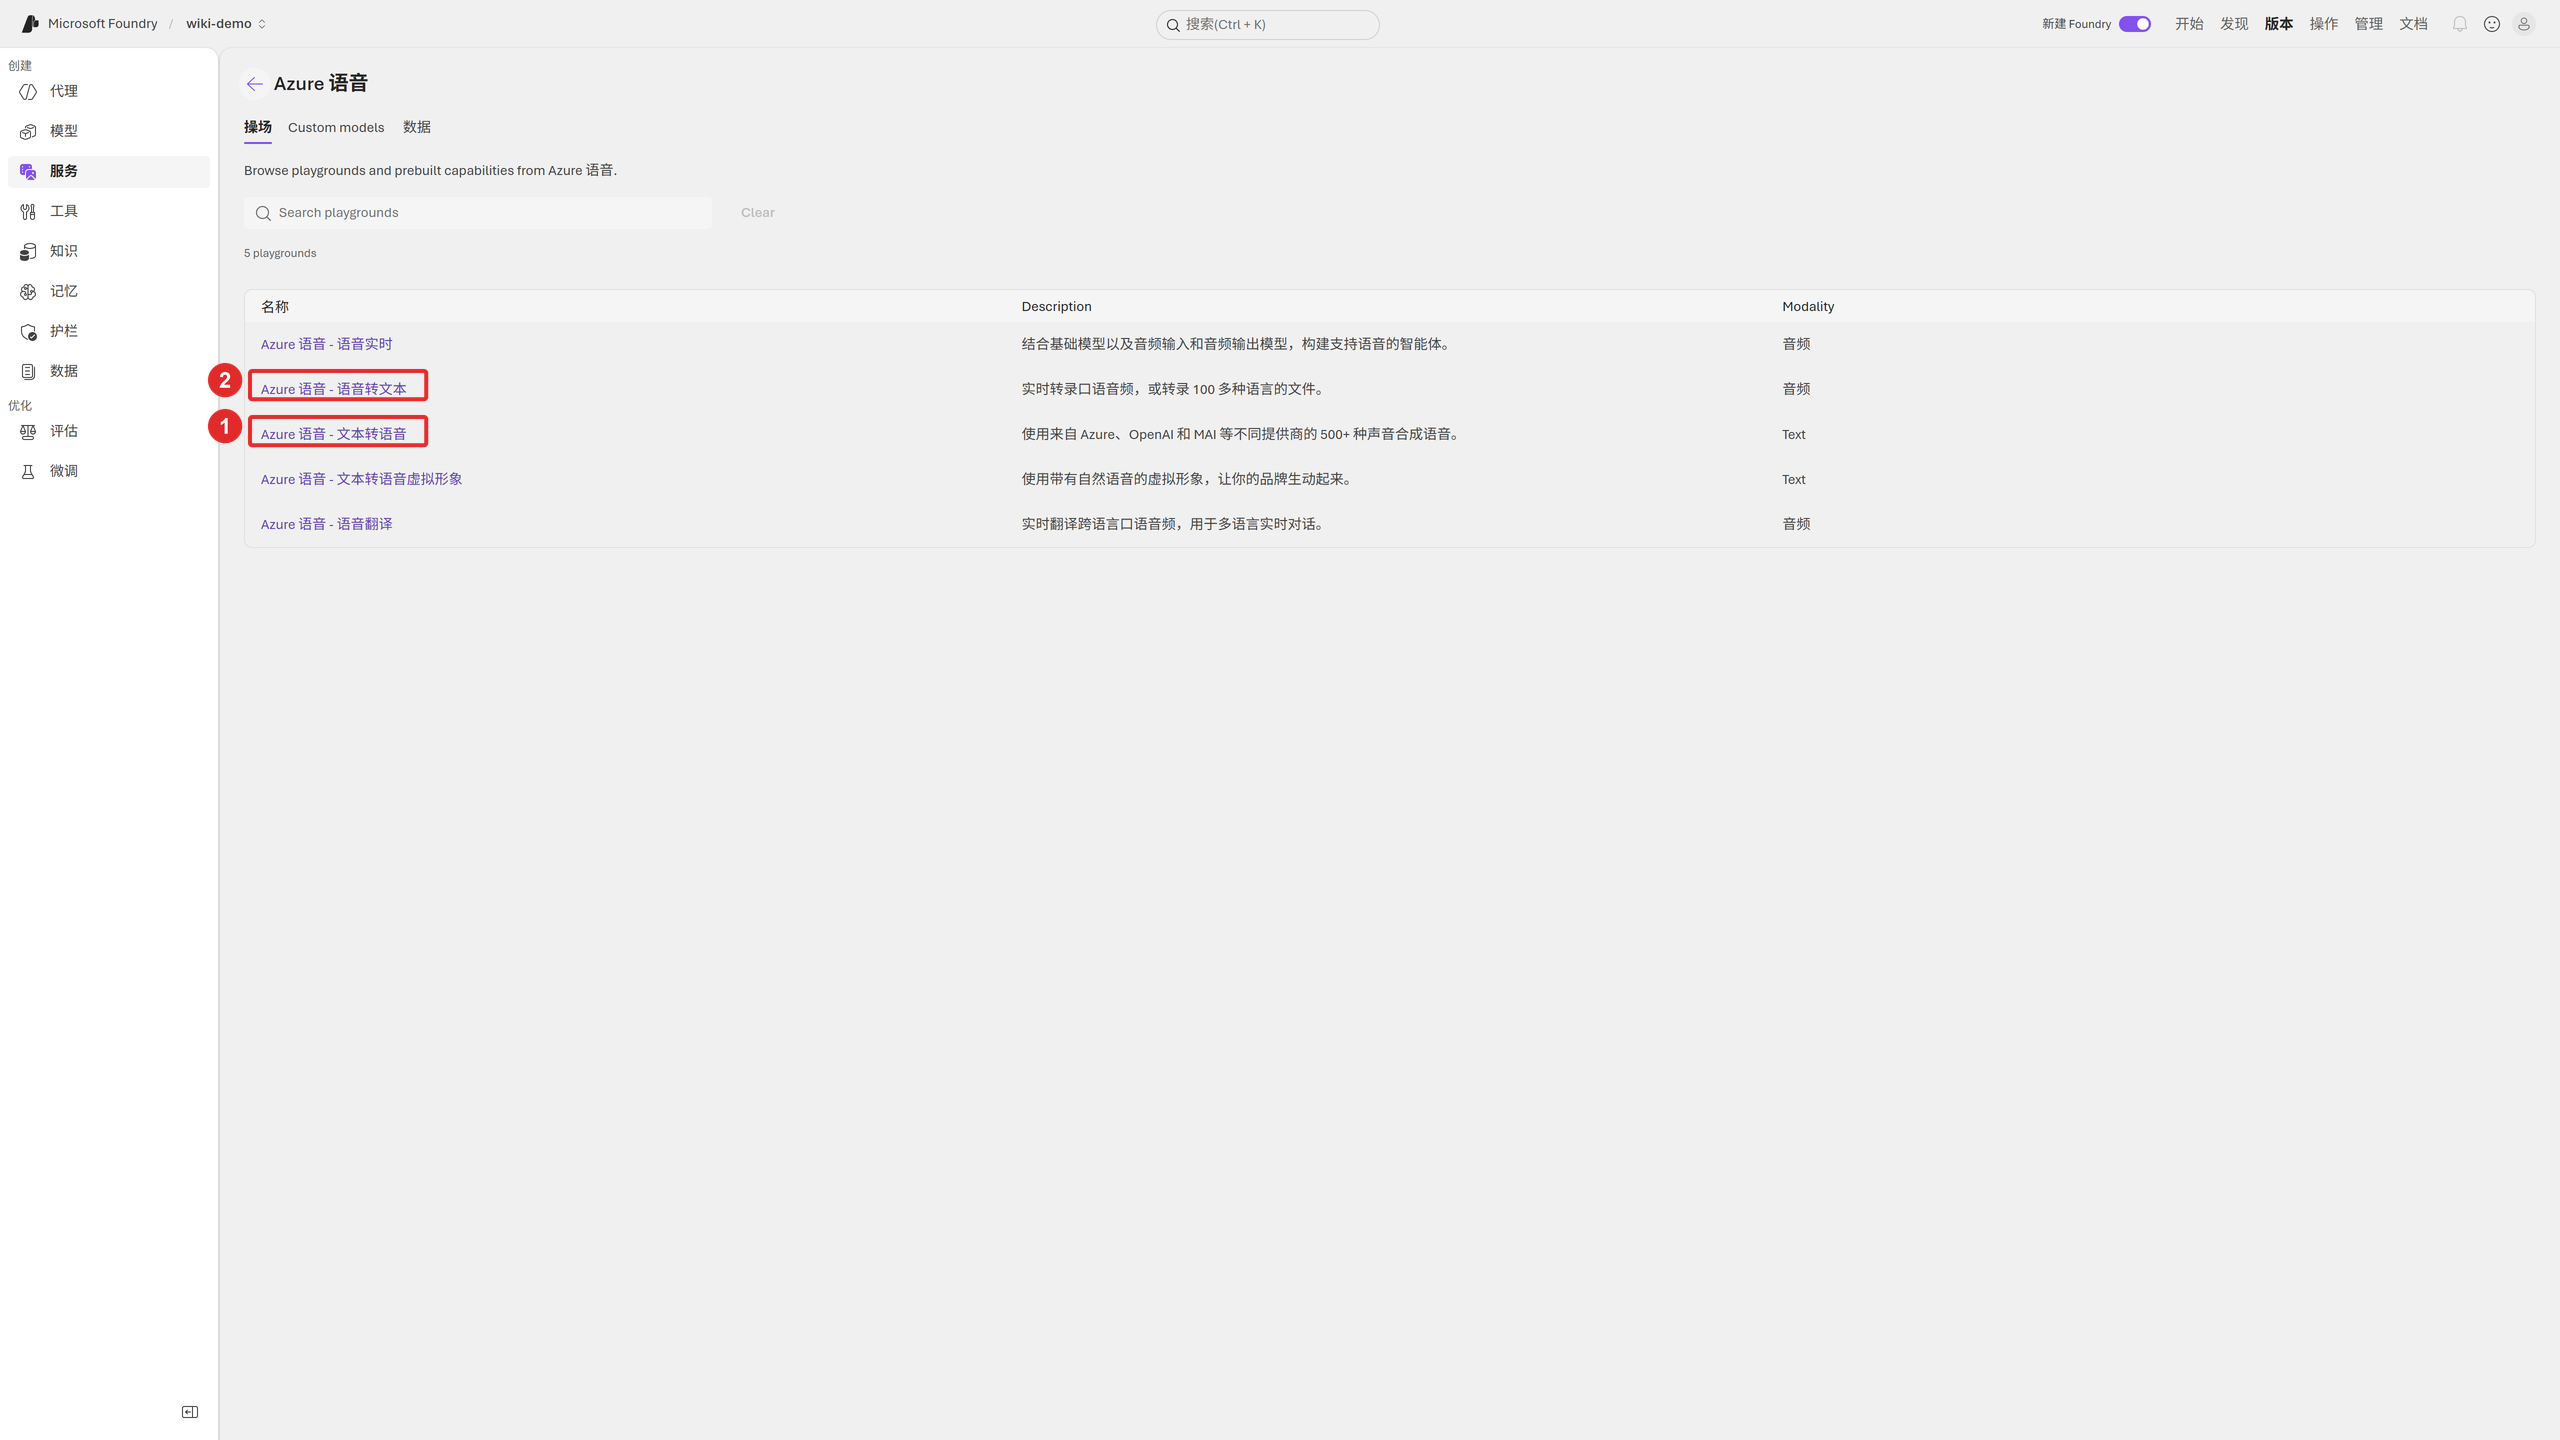
在“操场 / Playgrounds”中分别找到“文本转语音”和“语音转文本”。先打开文本转语音。

2. 选择中文声音
Section titled “2. 选择中文声音”进入文本转语音页面,在左侧“声音 / Voice”选择 Xiaoxiao。若常用列表没有该声音,选择“Browse all voices / 浏览全部声音”,搜索并点击 Xiaoxiao 名称,再保存。
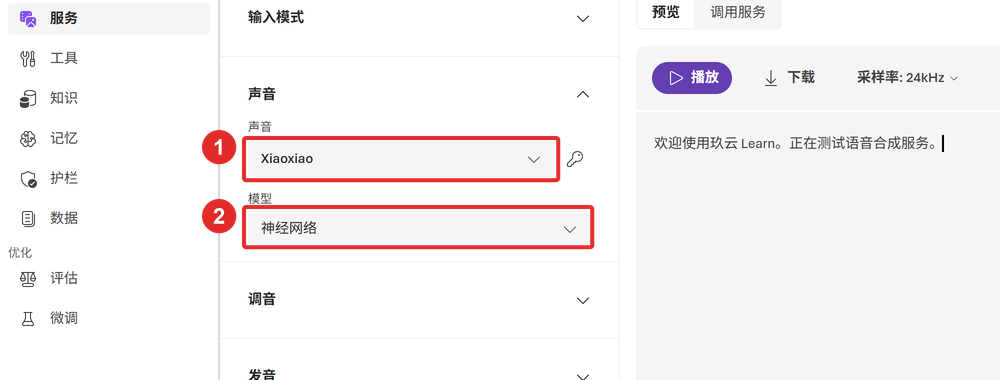
不要把它与 Xiaoxiao (Dialects) 混淆;最后到“调用服务”核对完整语音标识。
3. 输入中文并生成音频
Section titled “3. 输入中文并生成音频”回到页面,将“模型”设为“神经网络 / Neural”。本例最终语音名称为 zh-CN-XiaoxiaoNeural,中文普通话声音。初始声音与模型可能因页面版本而变化;如果提供语言选项,再明确选择“中文(普通话,简体)”。
在“预览 → 文本输入”中输入以下内容,再点击“播放”。
欢迎使用玖云 Learn。正在测试语音合成服务。

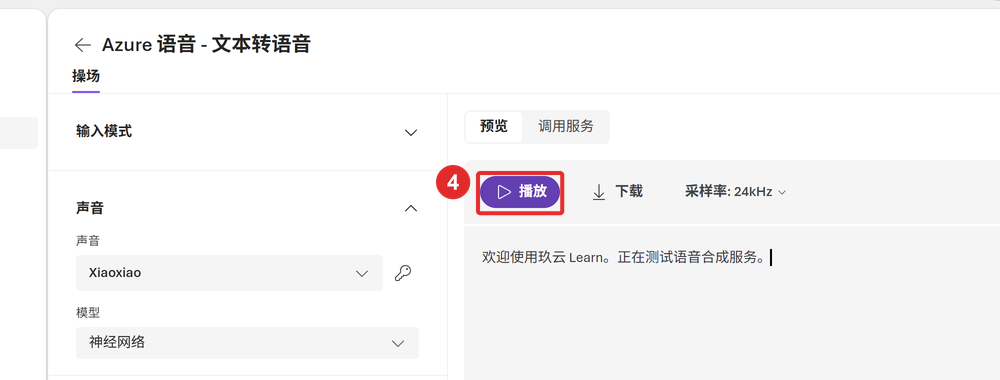
合成完成后点击“下载”。本次已经在页面实际合成并下载 WAV;下一步可直接上传自己刚下载的音频。

4. 查看程序接入参数
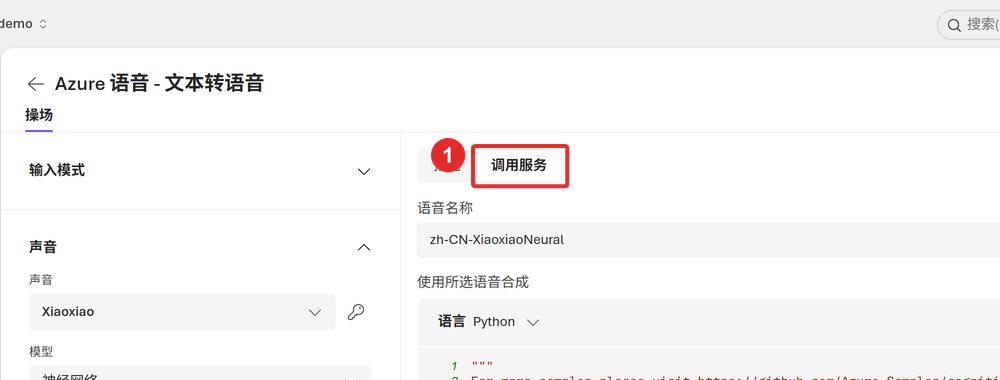
Section titled “4. 查看程序接入参数”点击右侧“调用服务 / Call service”。核对语音名称、项目终结点与资源密钥,再按页面生成的 Speech SDK 示例接入。公开截图已遮挡密钥;客户应从自己的资源获取。

| 参数 | 示例与填写方法 |
|---|---|
| 语音名称 | zh-CN-XiaoxiaoNeural |
| Speech 终结点 | 使用页面提供的 cognitiveservices.azure.com 地址 |
| 区域 | 使用实际资源区域;本例为 eastus2 |
| 密钥 | 从同一资源获取,通过环境变量或组织密钥管理方案提供 |
Speech 终结点与前面模型的 Responses 地址承担不同功能,不能直接互换。应用接入优先参考官方 Speech SDK 快速入门。
5. 进入语音识别并选择中文
Section titled “5. 进入语音识别并选择中文”点击页面左上方“返回”,回到 Azure 语音功能列表,打开“Azure 语音 - 语音转文本”。
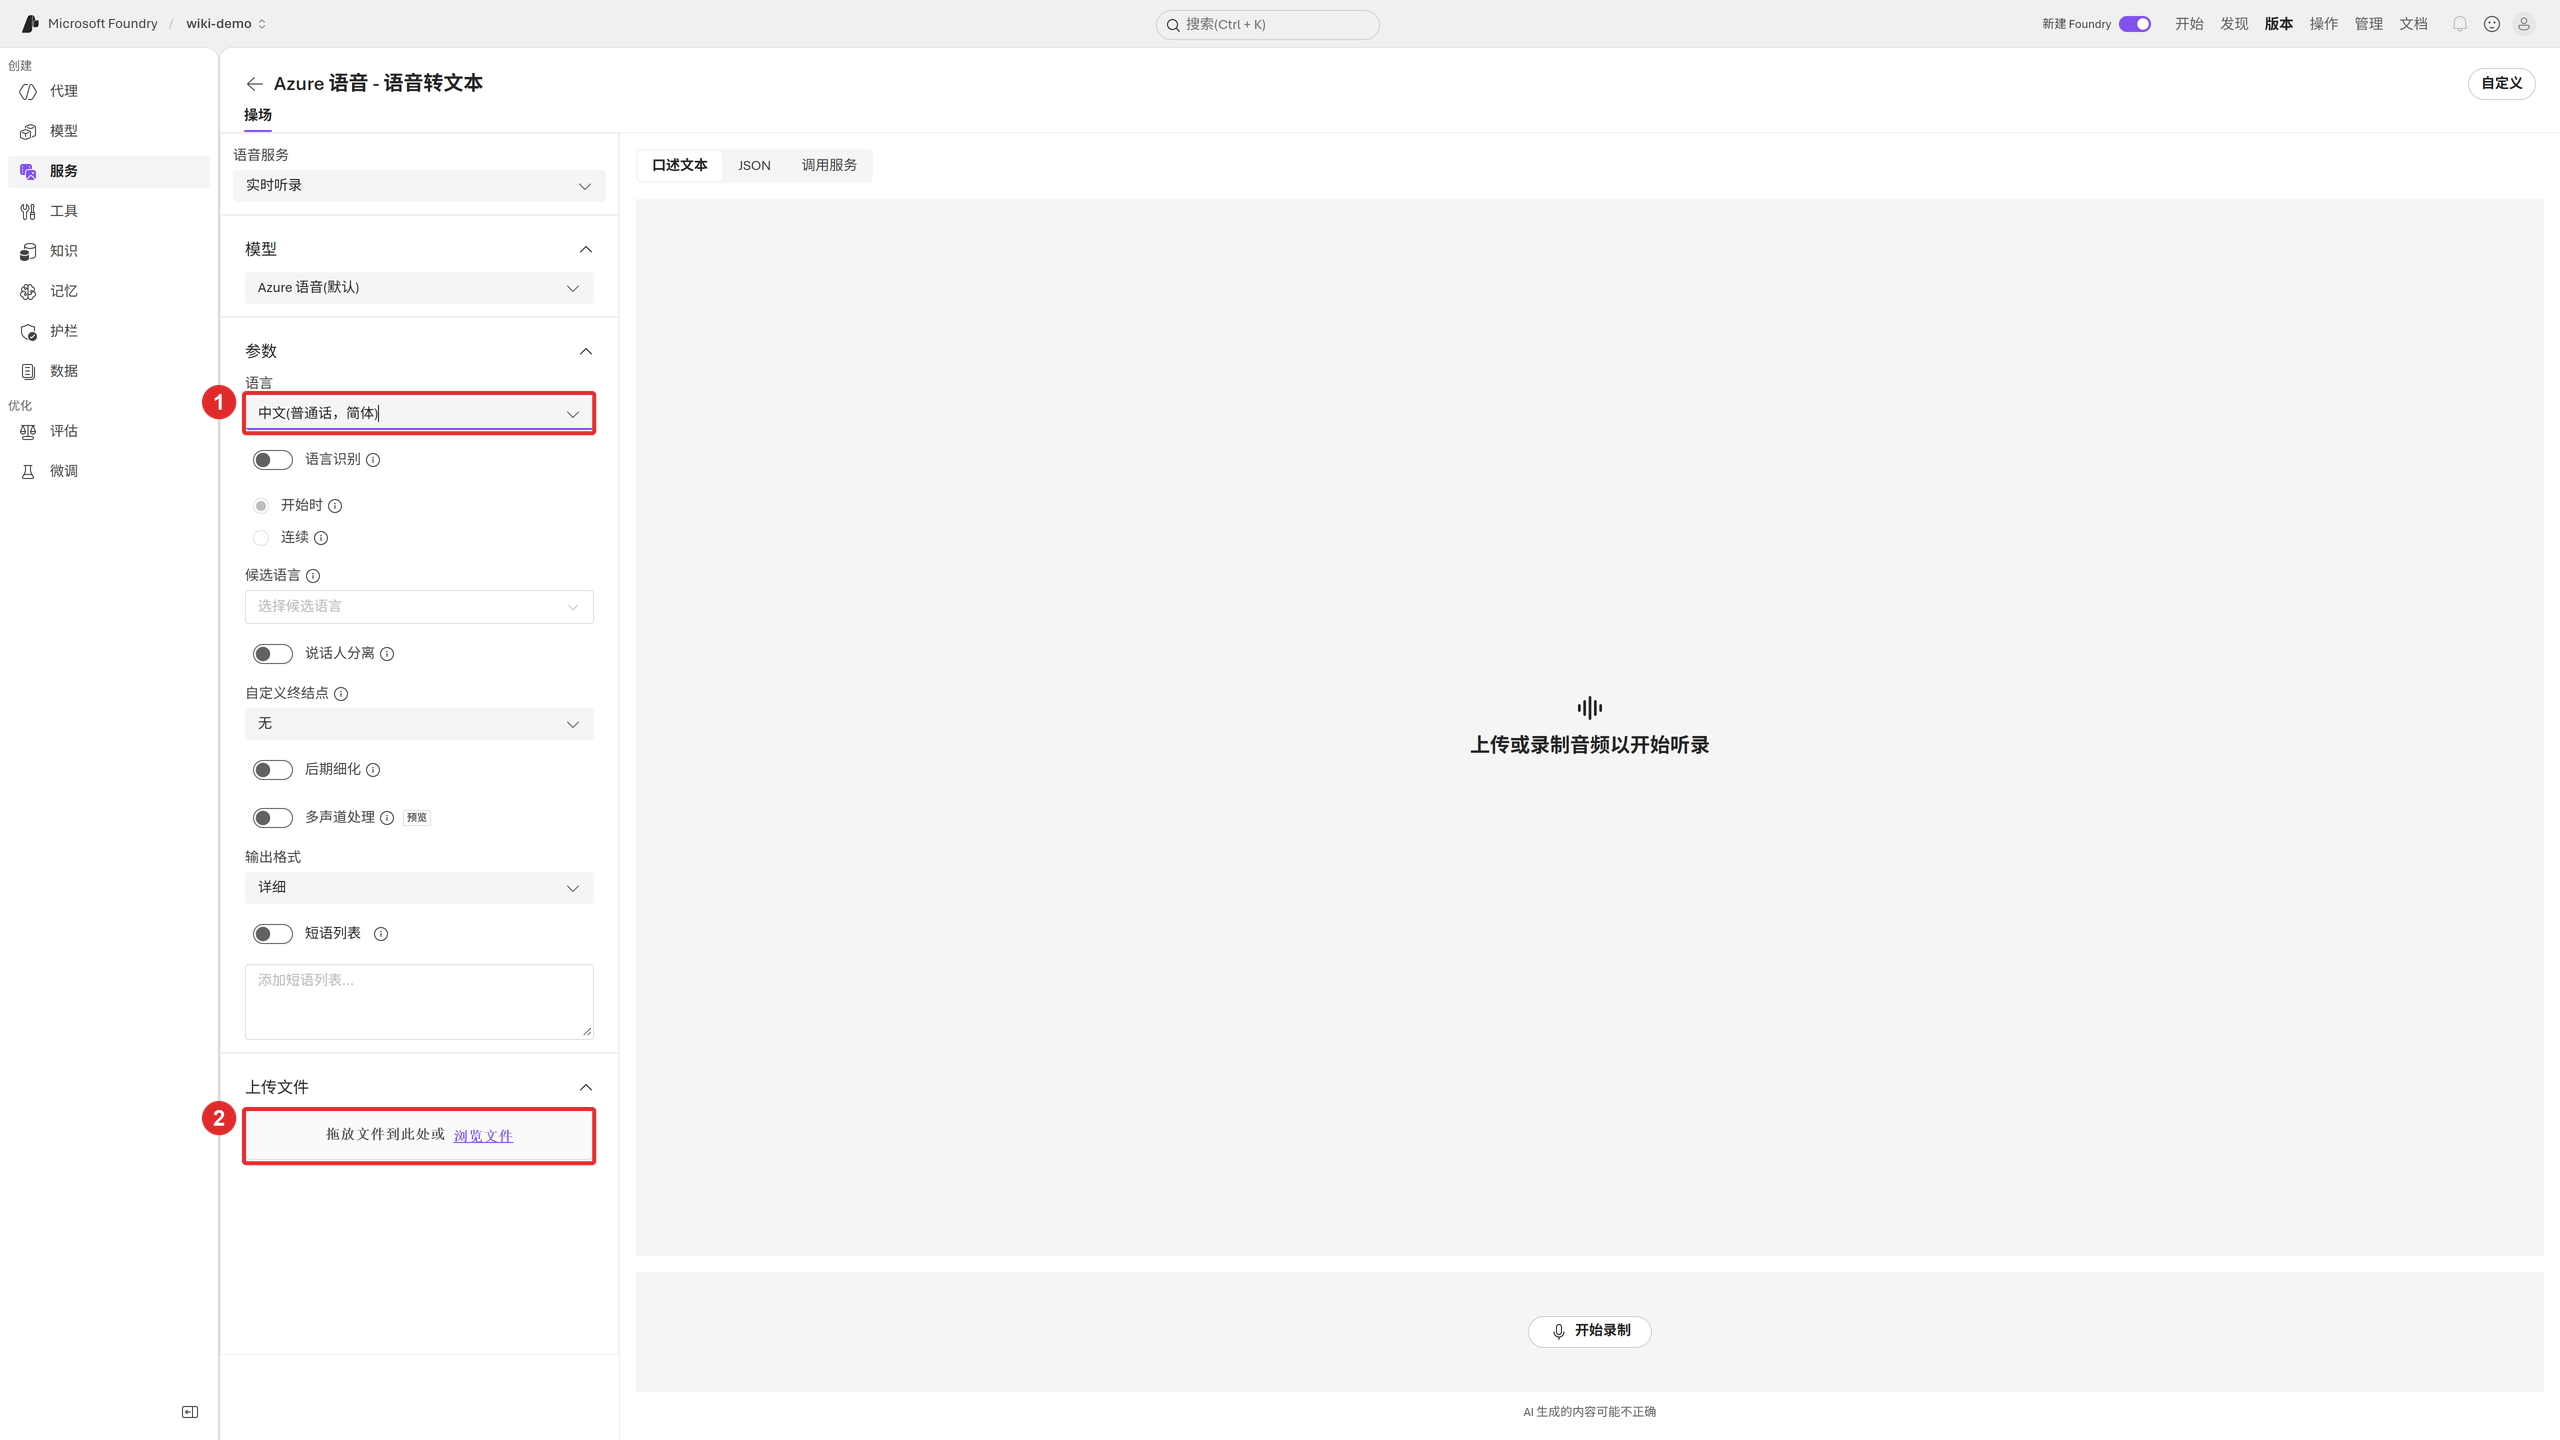
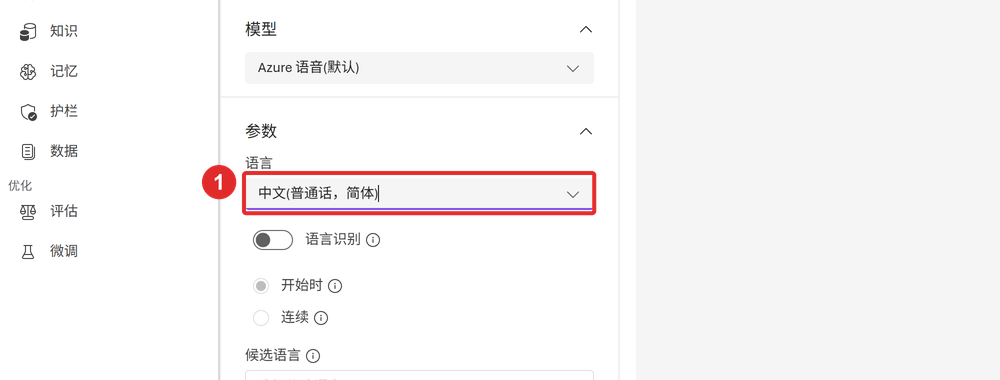
在左侧参数中,把“语言”设为“中文(普通话,简体)”。本例是单人短音频,先保留其余基础选项。
6. 上传音频并核对转写
Section titled “6. 上传音频并核对转写”在“上传文件”区域点击“浏览文件”,选择前面生成的 WAV。等待听录完成,在右侧查看转写;上传文件后可能自动开始处理。

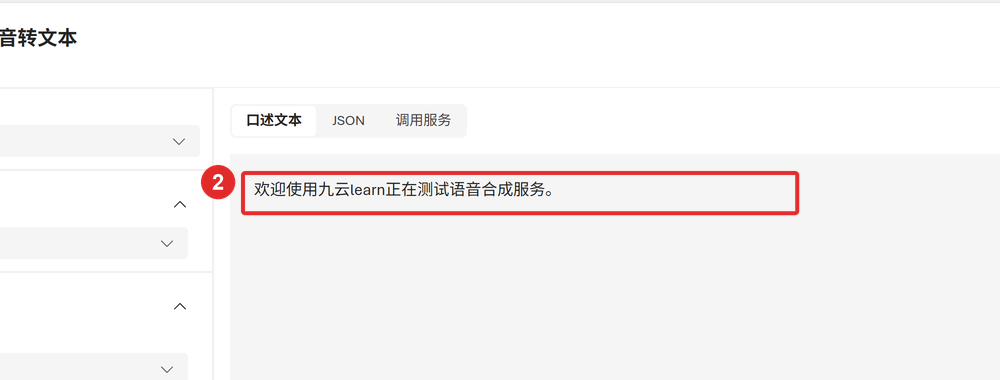
本次网页与接口均实际返回:“欢迎使用九云learn正在测试语音合成服务。”。其中“玖云”被识别成了“九云”,专有名称、标点和英文大小写仍需人工复核;可进一步评估短语列表等能力。
7. 如何判断测试完成
Section titled “7. 如何判断测试完成”| 检查项 | 本次结果 |
|---|---|
| 网页文本转语音 | 已实际播放并下载音频 |
| 网页语音转文本 | 已上传 WAV,返回中文转写 |
| 文本转语音接口 | HTTP 200,生成 16 kHz、单声道、约 4.71 秒 WAV |
| 短音频识别接口 | HTTP 200,RecognitionStatus 为 Success |
最后两项使用同一标准语音与测试文本进行独立接口验证。16 kHz 文件用于短音频 REST 测试;网页的采样率选项可能不同。长音频、批量听录和实时流式场景应分别选择官方对应接口。
| 现象 | 检查方向 |
|---|---|
| 找不到中文声音 | 清除多余筛选,再搜索声音名,并检查资源区域支持 |
| 语音名称与预期不一致 | 同时核对声音卡片和模型,最后到调用服务确认完整标识 |
| 上传后听录为空或语言错误 | 检查音频可正常播放、识别语言、音频格式和时长 |
| 401 / 403 | Speech 密钥、资源、区域和访问权限是否对应 |
| 429 | 查看 Speech 自身配额与并发;提高 GPT TPM 不会提高 Speech 配额 |